 NovelStory Studio
AI가 이번 회차에 8점을 줬습니다. 기분은 좋은데 정말 8점짜리 글일까요. 반대로 5점이 나왔다면 어디를 고쳐야 할까요. AI 소설 평가를 받아 본 작가가 부딪히는 문제는 점수 자체가 아니라, 그 점수를 어디까지 믿어도 되는지 판단할 방법이 없다는 점입니다.
점수를 그대로 믿기 어려운 네 가지 이유
- 무엇을 본 점수인지 모릅니다. 평가 항목과 기준을 모르면 8점이 문장에 대한 것인지 전개에 대한 것인지 알 수 없습니다.
- 맥락 없이 매긴 점수는 빗나갑니다. 앞 회차에 깔아 둔 복선을 모르고 읽으면 의도된 장면도 부족하다고 평가합니다. 반대로 맥락을 주었는데 그 맥락이 점수의 근거가 되어 버리면, 이번 회차를 읽은 평가가 아니게 됩니다.
- 근거 없는 점수는 검증할 수 없습니다. 숫자는 결론일 뿐 이유가 아닙니다.
- 고친 뒤에도 옛 점수를 믿기 쉽습니다. 평가는 그때의 원고에 대한 의견인데, 문장을 바꾼 뒤에도 같은 점수로 판단하게 됩니다.
이렇게 읽어야 합니다
- 1.기준이 공개되어 있어야 합니다. 어떤 항목을 어떤 질문으로 보았는지 읽을 수 있어야 점수의 뜻을 알 수 있고, 내 작품과 맞는지도 판단할 수 있습니다.
- 2.맥락은 이해용이고, 근거는 원고에서 나와야 합니다. 앞 흐름을 알려 주는 것은 좋지만, 점수의 근거는 평가한 회차의 원문이어야 합니다.
- 3.점수보다 근거를 먼저 읽고 원문과 대조합니다. 근거가 가리키는 대목이 실제로 원고에 있는지, 읽는 사람이 그렇게 느낄 만한지 확인하고, 맞지 않으면 그 항목은 건너뜁니다.
- 4.낡은 평가는 구분하고, 같은 기준끼리만 비교합니다. 원고가 바뀐 뒤의 평가는 낡은 것으로 다루고, 기준이 다른 점수는 나란히 놓지 않습니다.
- 5.반영 여부는 작가가 대목별로 고릅니다. 목표 독자와 내 의도에 맞는 의견만 골라 씁니다.
NovelStory Studio는 이렇게 해결했습니다
기준을 작가가 정합니다. 사용자 지표 기반 AI 평가는 작가가 만든 평가 지표로만 합니다. 도구막대의 「검토 기준」 → 「평가 지표」 탭에서 지표의 이름과 설명을 직접 적고, 막막하면 장르별 예시 지표를 「내 지표로 복사」해 고쳐 씁니다. 실행하면 뜨는 창에서 이번에 쓸 지표를 1~8개 고릅니다.
맥락과 근거를 나눕니다. 이전 회차 요약(직전 2개까지)과 참고 글은 맥락으로만 쓰이고, 점수의 근거는 이 회차 원고의 문단을 짚습니다. 결과 머리의 종합 점수 아래에 「내 평가 지표 · 이전 요약 2개·참고 글 포함」처럼 무엇을 함께 보냈는지 한 줄로 보이므로, 점수가 어떤 재료로 나왔는지 확인할 수 있습니다. 결과는 항목별 점수(0~10)와 근거가 붙은 문서로 남으니, 낮은 항목의 근거부터 읽고 해당 대목을 원고에서 다시 읽으면 됩니다.
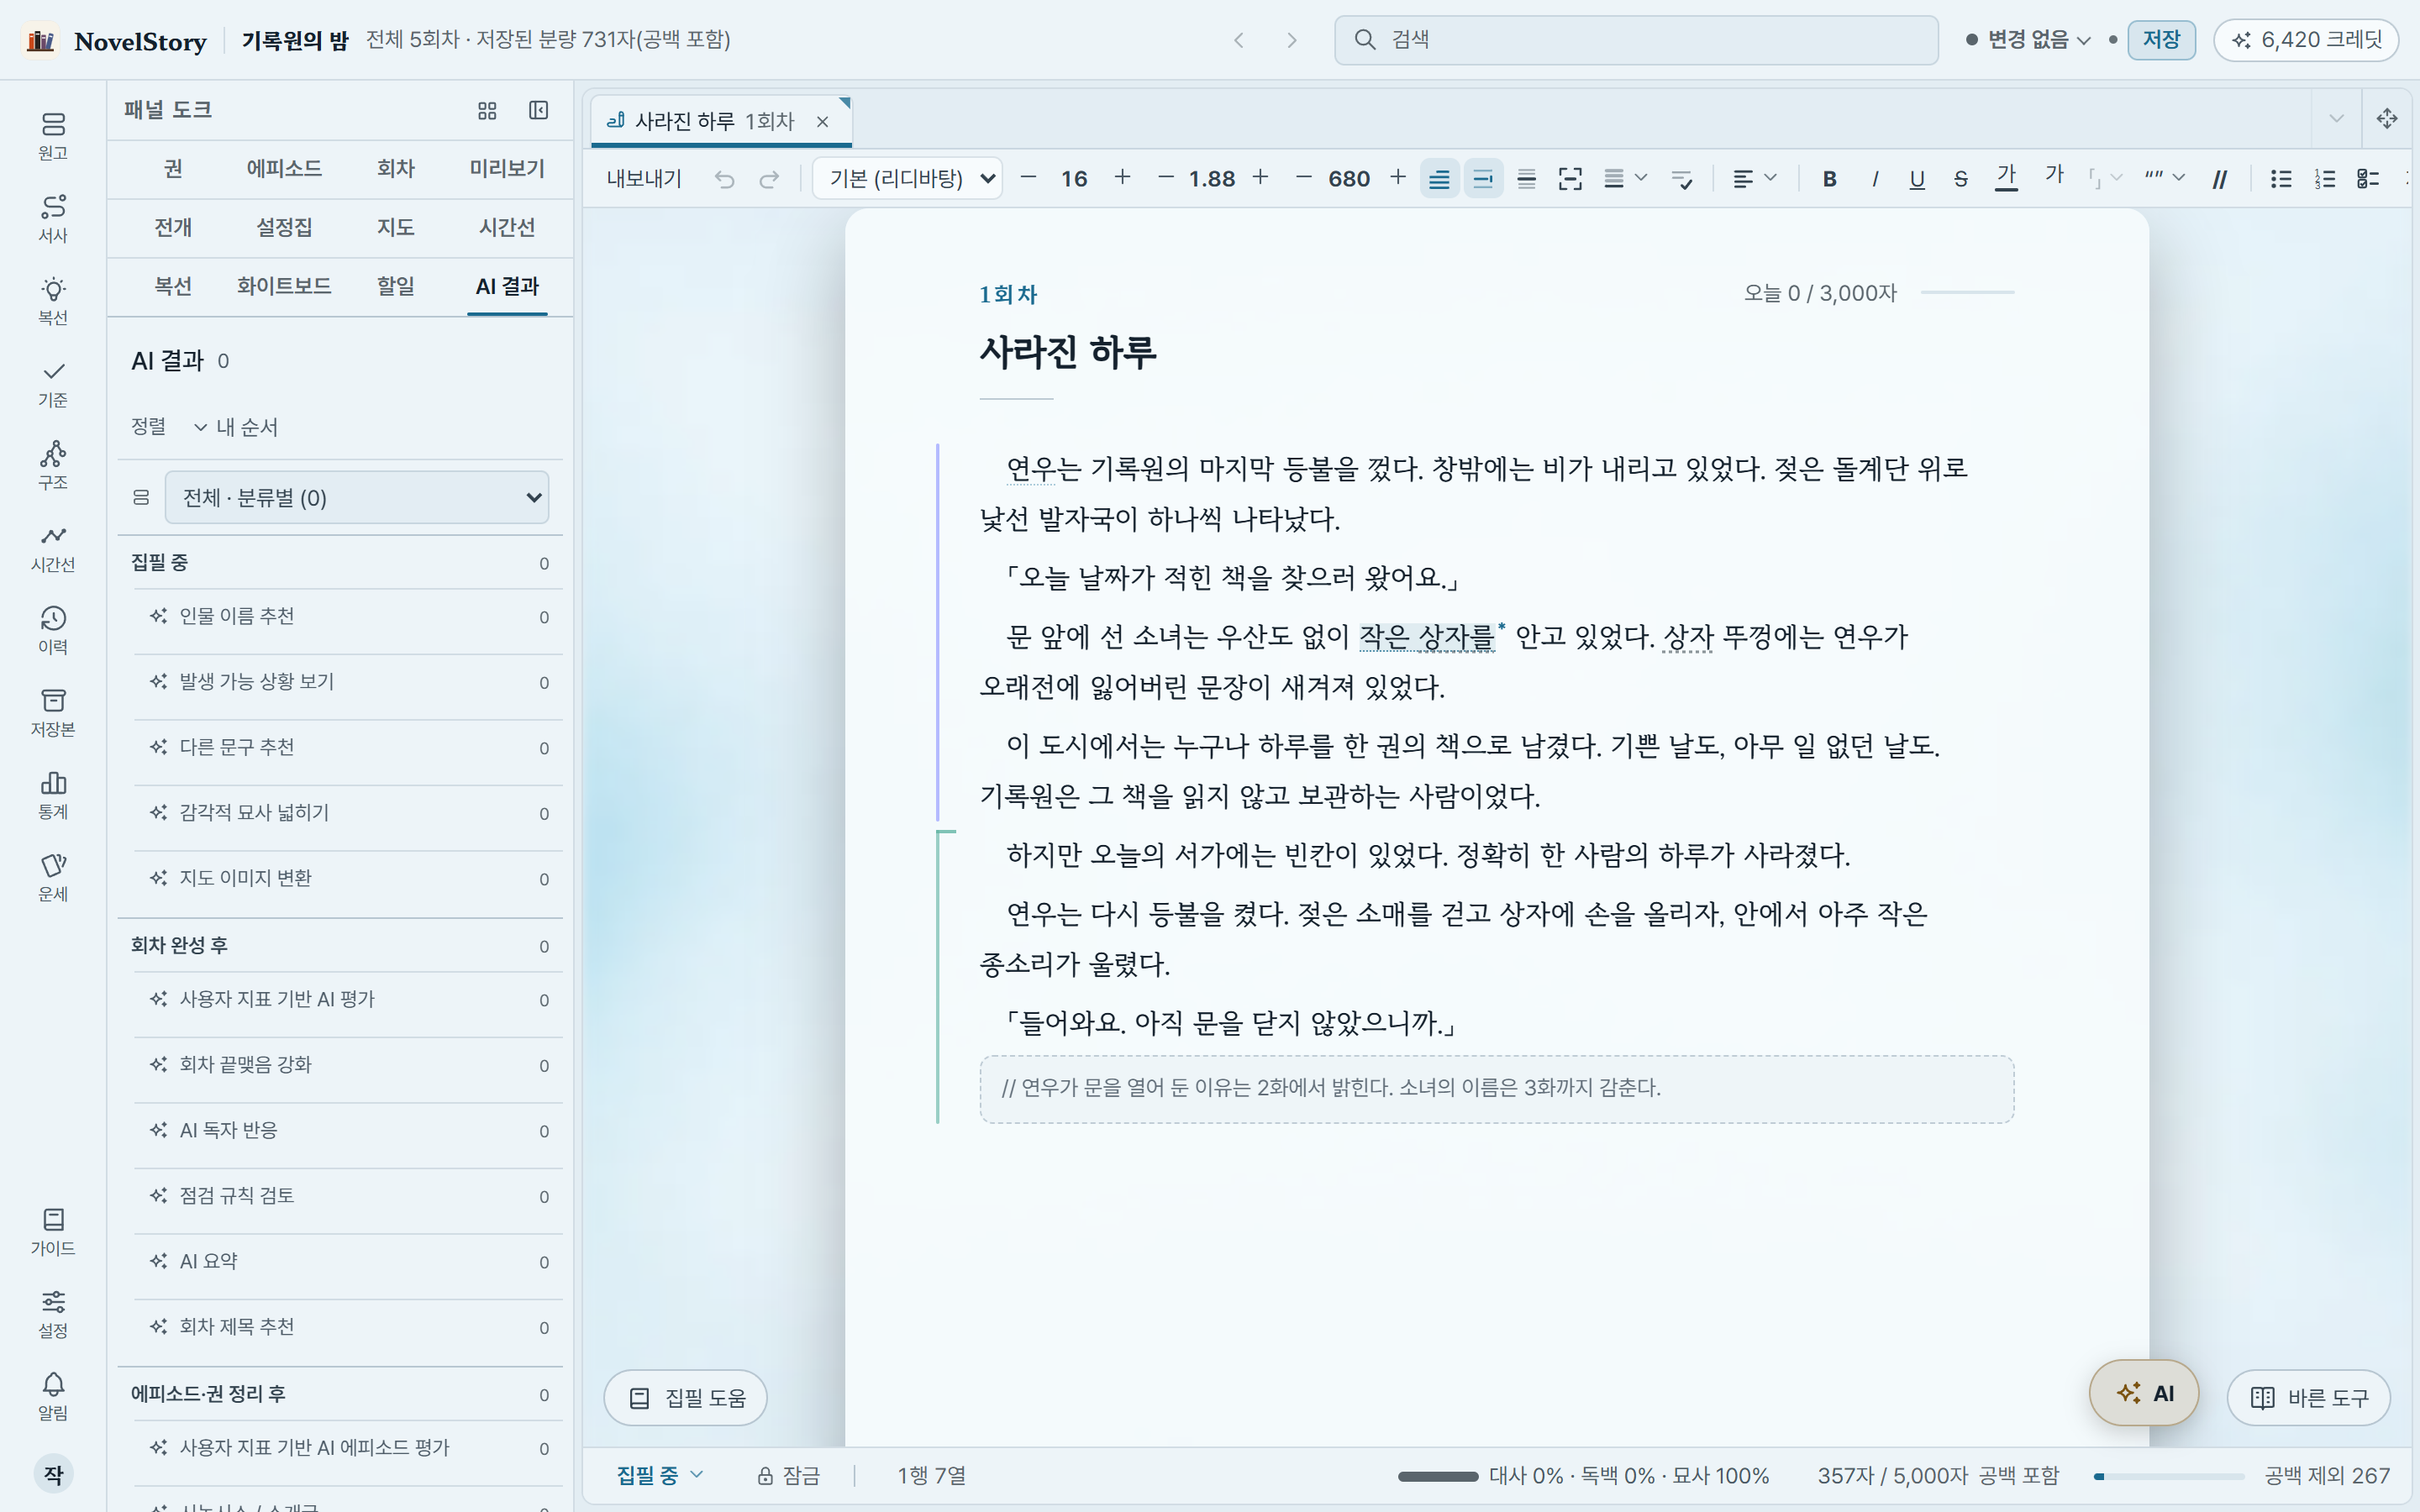
결과마다 평가 기준이 적혀 있습니다. 결과 머리 한 줄에 어떤 기준으로 평가했는지가 남으니, 점수는 기준이 같은 결과끼리만 견주세요. 고른 지표가 다르면 보는 항목이 달라 점수를 나란히 놓을 수 없습니다.
원고가 바뀌면 안내가 보입니다. 결과는 실행한 시점의 원고 기준입니다. 그 뒤에 원고를 고치면 결과에 다시 검토하라는 안내가 나타납니다. 점수를 올리려고 같은 회차를 반복해서 돌릴 필요는 없습니다.
AI는 원고를 자동으로 바꾸지 않습니다. 반영할 대목은 결과 문서에서 드래그하면 뜨는 작은 창에서 「할일 제목」을 적고 「등록」을 눌러 할일로 남기고, 퇴고할 때 작가가 직접 고칩니다.
여러 회차를 묶어 볼 때는 사용자 지표 기반 AI 에피소드 평가를 씁니다. 소속 회차의 최신 요약을 모아 평가하고, 같은 평가 기준과 참고 글을 고를 수 있습니다. 요약에서 빠진 사건은 평가에도 충분히 반영되지 않을 수 있습니다. 점수는 어디를 먼저 다시 읽을지 알려 주는 표지판 정도로 쓰는 것이 좋습니다.
다음 단계
평가를 읽고 할일로 남기는 방법은 사용자 지표 기반 AI 평가 가이드와 AI 결과 확인 가이드에 있습니다. 직접 해 보려면 시작하기로 이동하세요.